Этот материал для владельцев сайтов и начинающих вебмастеров - пошаговый разбор того, что такое canonical, зачем он нужен и как дубли страниц мешают индексации в поисковиках.
Частая ситуация: интернет-магазин с фильтрами и сортировкой генерирует десятки адресов с одинаковым контентом, а трафик при этом проседает. Причина почти всегда одна - робот поисковика не понимает, какая из версий страницы основная, и размазывает ссылочный вес между дублями вместо того, чтобы продвигать одну сильную страницу.
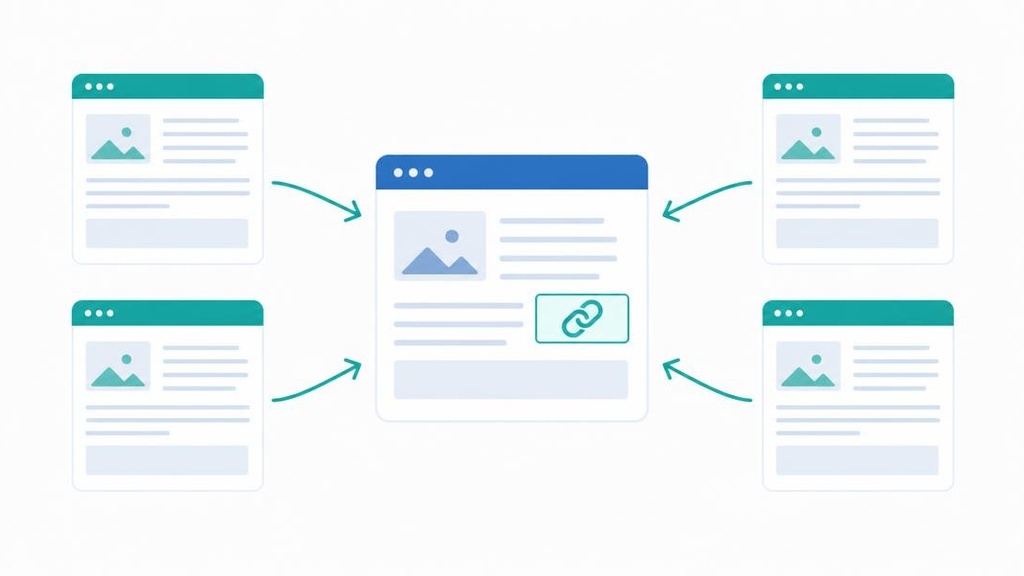
Rel canonical указывает поисковику предпочитаемую версию страницы для индексации - это не редирект, а рекомендация, при которой все версии URL остаются доступными для пользователя.
Эта статья - про техническое SEO для сайтов на WordPress и WooCommerce; для специфики агрегаторов и маркетплейсов с миллионами страниц подход к canonical может отличаться, здесь не разбираю.
Коротко:
- Canonical - это атрибут rel="canonical" в теге link, который сообщает поисковикам основной адрес страницы среди её дублей.
- Тег canonical размещается в head документа и содержит абсолютный URL, а не относительный путь.
- Дубли страниц чаще всего создают фильтры, сортировка, пагинация каталога, UTM-метки и доступность сайта по www и без www.
- В отличие от редиректа 301, canonical не закрывает доступ к дублирующим страницам - они остаются доступны пользователям.
- Self-referential canonical (страница, которая указывает сама на себя) - рекомендованная Google практика для уникальных страниц без дублей.
Что такое канонический URL и зачем он нужен
Канонический URL - это адрес страницы, который сайт явно называет основным среди нескольких похожих или одинаковых по содержанию адресов. Технически это реализуется через атрибут rel="canonical" в теге link, который размещается в head html-документа и содержит абсолютный URL предпочитаемой страницы.
Выглядит это так: <link rel="canonical" href="https://site.ru/catalog/tovar/" />. Такая строка говорит поисковику: даже если на этот товар ведут десять разных адресов с параметрами, учитывай при индексации именно этот href.
Зачем это нужно на практике. Когда у сайта есть несколько страниц с дублированным контентом, поисковики вынуждены сами решать, какую версию показывать в выдаче - и решают не всегда так, как хотелось бы владельцу сайта. Canonical убирает эту неопределённость и прямо указывает, какая страница должна индексироваться.
Есть и обратная ситуация: self-referential canonical. Это когда страница указывает в теге link rel canonical сама на себя. Google рекомендует делать так по умолчанию для всех уникальных страниц без дублей - это подстраховка на случай, если позже появятся параметрические версии адреса, о которых разработчик не подумал заранее.
На одном из проектов студии «Мельница» мы занимались каталогом спецтехники, где карточки товаров открывались и через основной раздел, и через акционный лендинг с тем же самым контентом. Без canonical обе страницы конкурировали друг с другом в выдаче и обе ранжировались слабо. После того как на дублирующей странице прописали canonical на основную карточку, вес ссылочный перестал делиться пополам, и страница закрепилась в топе по целевым запросам.
Важный нюанс: canonical - это рекомендация для робота, а не жёсткая команда. В большинстве случаев Google и Яндекс её соблюдают, но если содержимое страниц сильно различается, поисковик может индексировать страницу так, как считает нужным, игнорируя атрибут.
Что такое canonical в SEO и откуда берутся дубли страниц
Если смотреть на canonical именно со стороны SEO-задачи, а не технической реализации тега - это способ сайта «договориться» с поисковой системой о приоритете среди дублей, не удаляя и не блокируя лишние адреса для пользователей. Дальше - откуда эти дубли берутся на практике и как с ними справляется canonical.
Дубли страниц в SEO - это ситуация, когда по разным URL доступен один и тот же или почти идентичный контент. Для поисковика это выглядит как две разные страницы, которые соревнуются за одни и те же запросы, а для сайта в целом - как распылённый по дублям ссылочный вес и риск, что робот начнёт индексировать не ту версию.
Причины дублей разнообразны, и большинство из них появляется не из-за ошибок разработчика, а из самой логики работы каталога и домена. Фильтры и сортировки в карточках товаров, пагинация списков, несколько вариантов написания домена, версии сайта для мобильных устройств и UTM-метки для рекламных кампаний - всё это технически создаёт новые адреса с тем же или почти тем же содержанием. Задача канонических ссылок - заранее указывать поисковику, какая из этих версий основная, и не доводить дело до массового дублирования контента в индексе.
| Причина дублей | Как решает canonical |
| Фильтры и сортировка в каталоге | Все параметрические версии ссылаются canonical на страницу категории без фильтров |
| Пагинация каталога (страницы 2, 3, 4...) | Каждая страница пагинации указывает canonical либо сама на себя, либо на первую страницу списка, в зависимости от стратегии |
| www и без www, http и https | Canonical на выбранную основную версию домена закрепляет её как единственную для индексации |
| Мобильная версия на отдельном поддомене | Мобильная страница ссылается canonical на десктопную версию, если контент идентичен |
| UTM-метки и прочие параметры запросов | Canonical убирает параметры из индексируемого URL, оставляя чистый адрес страницы |
Чаще всего я вижу проблему именно в каталогах интернет-магазинов: фильтры по цене, бренду и характеристикам товаров умножают количество адресов в разы, и без canonical поисковый робот пытается индексировать каждую комбинацию параметров как отдельную страницу. Это не только размывает вес, но и впустую тратит краулинговый бюджет - лимит страниц, которые робот готов обойти за один заход.
Отдельно стоит сказать про UTM-метки: рекламные ссылки с параметрами вида ?utm_source=yandex технически создают новый адрес для той же страницы категории. Если не прописать canonical, в индексе может накопиться множество практически одинаковых URL - это типичная ошибка, которую я встречаю у клиентов, которые запускают контекстную рекламу без технической подготовки сайта.
Что такое URL-адрес и как он связан с canonical
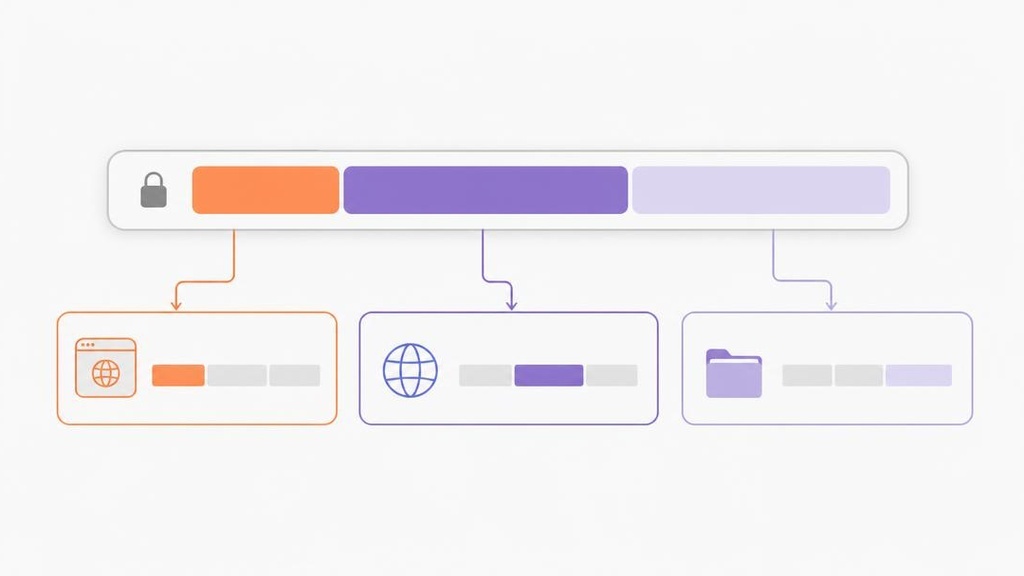
URL-адрес - это полный адрес ресурса в интернете: он указывает протокол (http или https), домен сайта и путь к конкретной странице на сервере. Например, в адресе https://start-luck.ru/blog/seo/ протокол https, домен start-luck.ru, путь /blog/seo/. Вводить URL-адрес правильно - значит писать его целиком, с протоколом и доменом, без пробелов и с учётом регистра, если сервер его различает: браузер и поисковые роботы читают строку как единый код уникального адреса страницы, и лишний символ или опечатка в домене уже даёт другой адрес.
Здесь важна разница между абсолютным и относительным путём. Абсолютный URL - это полный адрес вида https://site.ru/catalog/tovar, который работает сам по себе, откуда угодно. Относительный путь - это только часть после домена, например /catalog/tovar - он понятен внутри сайта, но без домена и протокола бессмысленен для внешней системы.
Именно поэтому в атрибуте canonical обязателен абсолютный URL с протоколом и доменом, а не относительный путь. Поисковый робот может встретить ссылку на страницу с разных поддоменов, по http и https, с www и без - и если в canonical указан только путь без домена, робот не поймёт, к какому именно сайту он относится. Короткий относительный href в теге canonical - частая техническая ошибка, которая обесценивает всю настройку.
На практике проще всего проверить адрес глазами: откройте страницу в браузере и посмотрите на адресную строку - если там нет протокола и домена (их браузер может скрывать визуально, но в коде страницы они обязаны присутствовать), значит в шаблоне используется относительный путь, и его нужно заменить на полный перед тем, как вписывать в canonical.
Как настроить canonical: тег, HTTP-заголовок, карта сайта, CMS
Настройка canonical зависит от типа страницы и от того, какая система управления сайтом (CMS) используется. Самый распространённый способ - указать тег link rel canonical прямо в head html-документа. Тег должен быть доступен на странице до закрытия head и ссылаться именно на абсолютный адрес; прописывают его вручную в файле шаблона или через инструменты CMS:
<head>
<link rel="canonical" href="https://site.ru/catalog/tovar" />
</head>
Для файлов, у которых нет html-разметки - PDF, документы, изображения - тег в head не подходит. Здесь используется HTTP-заголовок Link - сервер отправляет его вместе с файлом, и он задаёт canonical именно для PDF и других не-html файлов:
Link: <https://site.ru/docs/price.pdf>; rel="canonical"Третий способ - через карту сайта. Файл sitemap.xml задаёт канонические адреса для поисковых роботов: в него нужно включать только канонические версии страниц, без дублей с параметрами, пагинацией или utm-метками. Если в sitemap попадают неканонические адреса, это сигнал роботу, что указание canonical на странице может быть неточным.
На практике большинство владельцев сайтов настраивают canonical не вручную, а через плагины CMS, которые делают это автоматически. На WordPress таким инструментом чаще выступает Yoast SEO: плагин Yoast SEO управляет canonical-ссылками по умолчанию для всех типов записей, и его достаточно выбрать и указать базовые настройки один раз для всего проекта. Он зарубежный, но доступен и работоспособен из России, оплата идёт через подписку внутри WordPress-экосистемы без отдельных ограничений для рунета. В остальных CMS принцип похожий - ищите раздел SEO-настроек или один из плагинов для метатегов, там обычно есть поле для ручного указания canonical на случай, если автоматика ошиблась.
| Способ настройки | Когда применять | Пример реализации |
| HTML-тег link rel canonical | Обычные html-страницы, ручная правка шаблона | <link rel="canonical" href="..." /> в head |
| HTTP-заголовок Link | PDF, изображения и другие не-html файлы | Link: <url>; rel="canonical" в ответе сервера |
| Файл sitemap.xml | Массовое указание канонических адресов для робота | В карте перечислены только канонические url без дублей |
| Плагин CMS (Yoast SEO и аналоги) | Автоматическая настройка без правки кода | Поле canonical url в настройках записи/страницы |
Частые ситуации: пагинация, мобильная версия, интернет-магазин, hreflang
На практике большинство вопросов про canonical возникают в одних и тех же ситуациях, и дальше - разбор самых частых из них. Остальные похожие случаи обычно сводятся к этим четырём схемам, если понять логику - решение находится быстро.
Первая ситуация - страницы пагинации в каталоге, когда товаров много и они разбиты на страницы вида /catalog/page/2/. Здесь правильнее сделать canonical self-referential - то есть каждая страница пагинации ссылается canonical на саму себя, а не на первую страницу каталога. Если поставить canonical на первую страницу для всех остальных, товары со второй и третьей страницы фактически исключаются из индекса, и это частая ошибка на крупных каталогах.
Вторая ситуация - отдельная версия сайта для мобильных устройств на поддомене, например m.site.ru. Мобильная версия страницы должна ссылаться canonical на десктопную версию - это стандартная рекомендация, которая снимает дубль между основной и мобильной версией для поисковых систем. Обратная связь тоже нужна: десктопная страница может указывать alternate на мобильную, но каноническим остаётся адрес основного сайта.
Третья ситуация - карточки товаров интернет-магазина с похожими модификациями, например одна модель в разных цветах или размерах. Если у каждой модификации своя страница с минимальными отличиями, логично выбрать одну основную карточку и сделать на неё canonical с остальных - это избавляет от внутренней конкуренции похожих страниц за одни и те же запросы. Такое решение часто принимают компании, у которых бизнес завязан на большой ассортимент: клиенты видят все модификации через выбор на странице, а не через отдельные url в выдаче.
Отдельная история - мультиязычные сайты. Здесь canonical не подходит вообще: разные языковые версии одной страницы - это не дубли, а разный контент для разных аудиторий. Для них применяется hreflang - атрибут, который указывает поисковику, какая версия страницы предназначена для какого языка и региона. Hreflang применяется вместо canonical для мультиязычного контента: если на проекте стоит и canonical на одну языковую версию, и hreflang на остальные одновременно, это создаёт противоречивый сигнал, и часть языковых версий может выпасть из индекса.
Если возникает вопрос, можно ли ставить canonical на другой домен - технически можно, и это иногда нужно, например при переезде контента без полного переноса сайта. Но для большинства проектов такой случай временный: лучше оформить полноценный 301 редирект, который заменяет старую страницу новой полностью, а canonical на чужой домен оставлять постоянной практикой не стоит - слишком легко потерять контроль над тем, что из этого попадёт в индекс.
Типичные ошибки настройки canonical и как их найти
Большинство проблем с canonical сводятся к нескольким повторяющимся ошибкам. Первая - несколько тегов canonical на одной странице сразу: одна CMS ставит свой, плагин SEO добавляет второй, шаблон темы - третий. При конфликте поисковик сам выбирает, какому верить, и это редко совпадает с задумкой владельца сайта.
Вторая частая проблема - относительный href в теге вместо абсолютного адреса (этот момент я уже разбирал выше, здесь важно только держать его в голове как источник ошибок). Третья - canonical указывает на страницу, которая сама закрыта через noindex или заблокирована в robots.txt. Получается противоречивый сигнал: «считай эту страницу основной», но сама основная страница недоступна для сканирования или индексации.
Четвёртая ошибка - рассогласование между тегом canonical и данными в sitemap. Если в sitemap перечислены страницы с параметрами и utm-метками, а canonical на них указывает на чистый URL без параметров, поисковик получает два разных набора сигналов об одном и том же контенте. Похожая история с редиректом: если страница одновременно отдаёт 301 редирект и несёт свой canonical, это лишний сигнал - редирект уже решает вопрос приоритета сам.
Эти ошибки снижают позиции страницы в выдаче: поисковик тратит ресурсы сканирования на дубли, а сигналы ссылочной массы и поведенческих факторов размываются между версиями страницы вместо накопления на одной. Итог - просадка трафика, а продвижение сайта тормозится, хотя формально страницы индексируются. Это касается и платной рекламы: если на разные url с рекламными метками ссылается одна и та же реклама, аналитика по кликам и конверсиям разъезжается по дублям вместо одной страницы.
Регулярная проверка - лучшая страховка от этих ошибок, и для неё подойдёт инструмент проверки URL в Google Search Console - он показывает, какой canonical выбрал Google (выбранный пользователем или назначенный самим поисковиком) и фактический статус индексации. У Яндекс.Вебмастера для этого есть раздел технического аудита сайта, куда заходят вебмастера для диагностики: там видно расхождение между указанным canonical и тем, какая версия реально отображается в результатах выдачи. Такой регулярный анализ по обеим панелям поиска - базовая часть технического SEO-аудита для любого сайта.
Что такое URL в Telegram и когда canonical вообще не нужен
URL в Telegram - это обычный веб-адрес вида t.me/username, который используется как ссылка на канал, бота или инвайт в закрытый чат: технически это такой же URL-адрес, как и у любой страницы сайта, просто с доменом t.me - дальше идут специальные виды путей (каналы, боты, инвайты), и каждая ссылка должна вести на свою конкретную сущность, а не на общий раздел. Напрямую к canonical это не относится, но принцип дублей тот же: если пост опубликован на сайте и репостом в Telegram-канале со своей веб-версией страницы, одинаковым содержимым доступны сразу два адреса. Там, где у такой веб-версии есть собственная индексируемая страница, работает тот же принцип приоритетного адреса, что и на обычном сайте.
Но важно понимать и обратное: canonical - не универсальное решение для всех страниц сайта. Если содержимое страницы полностью уникально и дублей у неё нет - прописывать тег ради формальности не нужно, лишний технический элемент на странице без дублей ничего не даёт, его можно спокойно оставить без внимания и не считать проблемой.
Отдельный случай - разные языковые версии одного сайта. Здесь canonical применять неправильно: нужен атрибут hreflang, который сообщает поисковику, что страницы на разных языках должны стать отдельными результатами в своей локали, а не объединяться в одну. Это же касается страниц, которые должны остаться проиндексированными отдельно осознанно - например, разные акции с похожим, но не дублирующим контентом. Проигнорировать разницу между canonical и hreflang - частая причина, по которой часть языковых версий сайта выпадает из выдачи.
Если хотите привести canonical на сайте в порядок прямо сейчас, вот короткий чек-лист:
- Найти дубли через сканер сайта или вручную по типовым случаям (параметры, пагинация, мобильная версия)
- Прописать canonical на единственную приоритетную версию каждой страницы, используя абсолютный URL
- Проверить, что canonical не ведёт на страницу с noindex или заблокированную в robots.txt
- Свериться с sitemap - адреса там должны совпадать с canonical-версиями
- Проверить результат через Google Search Console и Яндекс.Вебмастер через 1-2 недели после изменений
Если разбираться с canonical самостоятельно не хочется, или сайт стоит на незнакомой CMS, где непонятно, куда лезть с тегами, - на Kwork такую задачу делают за небольшие деньги, обычно это несколько сотен - пара тысяч рублей за настройку canonical или базовый технический аудит. Сервис Kwork удобен тем, что можно выбрать исполнителя под конкретную CMS и получить доступ к результату без долгой переписки.
У одного из клиентов после наведения порядка с canonical в индексе Google перестали мелькать посторонние адреса с utm-метками - раньше по запросам бренда в выдаче иногда всплывали ссылки с рекламными хвостами вместо чистой страницы товара.
Данная статья основана на личном опыте автора и актуальна на момент публикации. Интерфейсы сервисов и алгоритмы поисковых систем регулярно меняются - рекомендую проверять актуальность инструкций на официальных ресурсах. Если у вас остались вопросы - задайте их в комментариях.
Список литературы
- Google Search Central - Consolidate duplicate URLs // developers.google.com
- Google Search Central - What Is URL Canonicalization // developers.google.com
- Яндекс - Как указать роботу на предпочитаемую страницу (canonical) // yandex.ru
- Яндекс - Дублирование страниц // yandex.ru